Como mixar voz e música com ducking sem esmagar a fala
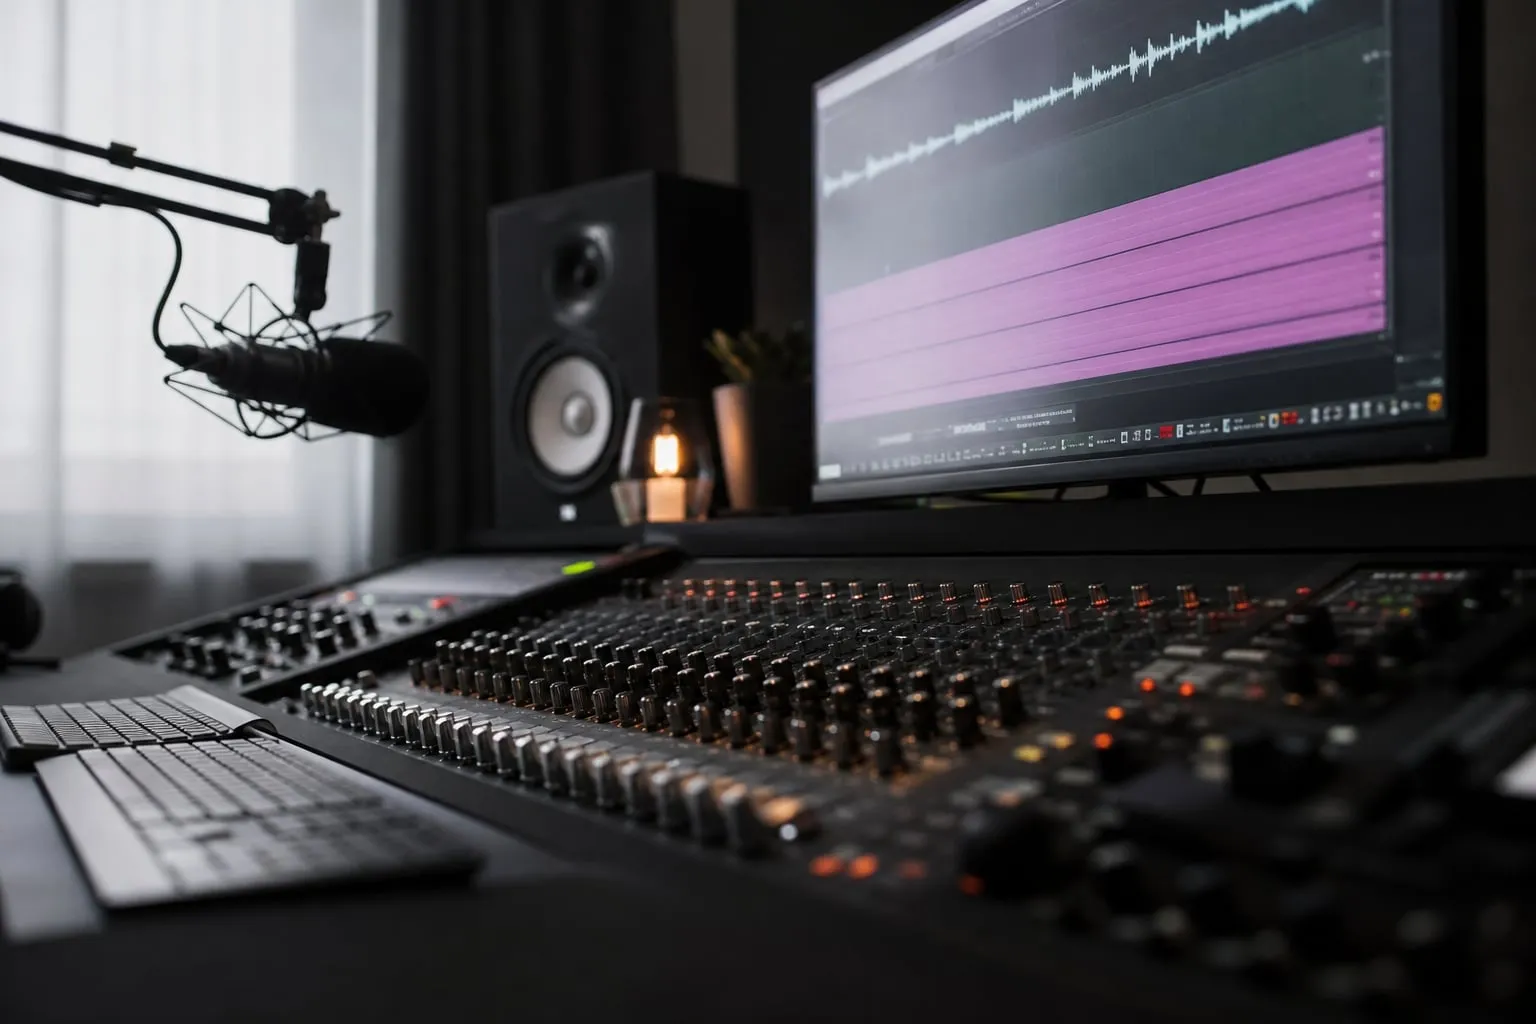
Como mixar voz e música fica mais fácil quando a trilha abre espaço antes de a fala começar. Use automação de volume para baixar a música por frase e um ducking moderado para corrigir variações menores. Assim, a voz mantém presença sem ser esmagada por compressor ou limiter.
A técnica funciona em entrevistas, vídeos institucionais, documentários, podcasts filmados e reels com narração. O resultado depende menos de um preset e mais do momento em que a música desce, da velocidade do retorno e do espaço deixado para a última sílaba.
Por que a música encobre a fala mesmo em volume baixo?
A música pode mascarar a voz quando ocupa as mesmas faixas de frequência e muda de intensidade junto com as palavras. Violões, pianos, sintetizadores e caixas de bateria costumam acumular energia entre 1,5 kHz e 4 kHz, região que ajuda a entender consoantes como t, k e s.
O problema também aparece quando a trilha tem ataques rápidos. Uma batida que entra antes de uma frase chama a atenção por alguns milissegundos, mesmo que o nível médio da música pareça aceitável no medidor.
Antes de inserir qualquer efeito, faça três ajustes manuais:
- Corte silêncios longos e respirações excessivas na faixa de voz, sem apagar todas as pausas naturais.
- Ajuste o ganho dos clipes para que frases muito baixas não dependam de uma compressão pesada.
- Deixe a trilha alguns decibéis abaixo da voz e escute em fones, monitores pequenos e no alto-falante do celular.
Essa preparação evita pedir ao compressor uma tarefa que pertence à edição. Se a narradora termina uma frase em volume baixo, aumentar aquele trecho com clip gain costuma soar mais natural do que elevar a compressão da gravação inteira.
Automação de volume: o controle que decide o momento do ducking
Automação de volume é a criação de pontos na linha de ganho para subir ou baixar uma faixa ao longo do tempo. Em vez de reduzir a música durante todo o vídeo, você cria uma curva ligada ao texto falado.
Comece pela faixa ou pelo bus da música. Um bus é um canal que reúne várias pistas, como trilha, efeitos musicais e instrumentos. Automatizar esse bus evita desenhar a mesma queda em três ou quatro faixas separadas.
Use este fluxo em qualquer DAW, no Fairlight do DaVinci Resolve, no Adobe Audition, no Premiere Pro ou no Reaper:
- Coloque a voz em solo e marque o início e o fim de cada frase.
- Ative a visualização de volume no bus da música.
- Crie quatro pontos ao redor de cada fala: antes da entrada, no começo da queda, no fim da queda e depois do retorno.
- Baixe a música entre 4 e 8 dB como ponto de partida.
- Faça a trilha voltar entre 150 e 400 ms depois da última sílaba, conforme o ritmo da cena.
O ponto mais fácil de errar fica no final da frase. Se a música sobe no instante em que a pessoa termina de falar, a cauda de palavras como voz, vez e mais desaparece. Mova o ponto de retorno para depois da consoante final, não apenas depois do marcador de fala.
Para uma narração lenta, uma queda de 300 ms antes da frase pode soar discreta. Em uma edição rápida, 80 a 150 ms costuma preservar melhor o ritmo. A curva também importa: uma descida linear pode parecer mecânica, enquanto uma curva suave com início mais rápido costuma esconder melhor a mudança.
Como usar ducking sem transformar a trilha em um elevador
Ducking é a redução automática da música quando um sinal de controle, normalmente a voz, ultrapassa um limite. No compressor com sidechain, a voz aciona o compressor inserido na música. O ganho da trilha cai e retorna quando a fala baixa.
Use o ducking para acompanhar mudanças pequenas que a automação principal não cobre. Ele funciona bem quando duas pessoas alternam falas, quando o volume do entrevistado varia ou quando uma frase foi regravada com nível diferente.
Uma regulagem inicial segura para a música é:
- Ratio entre 2:1 e 4:1.
- Attack de 5 a 20 ms.
- Release de 150 a 300 ms.
- Redução de ganho entre 2 e 5 dB na maior parte das frases.
Esses valores são pontos de partida, não uma receita. Attack rápido demais pode fazer a trilha perder o ataque musical. Release curto demais cria um efeito de bombeamento, com o volume subindo e descendo entre palavras. Release longo demais deixa a música escondida depois que a frase acabou.
O compressor deve receber a voz pelo sidechain, mas a voz não precisa passar pelo compressor. Em muitas sessões, o melhor caminho é desenhar uma queda de 5 dB na automação e deixar o sidechain reduzir apenas mais 1 ou 2 dB nas palavras que escapam. Esse arranjo mantém a curva previsível e evita que cada respiração altere a trilha.
Se você usar o compressor com sidechain sozinho, filtre o sinal de controle. Um filtro passa-altas no sidechain reduz o efeito de plosivas, como o estouro de p e b, que pode disparar o ducking de forma exagerada. O filtro afeta o detector, não precisa ser aplicado à voz que o público escuta.
Quando compressor e limiter pioram a inteligibilidade
O compressor na voz reduz a diferença entre frases altas e baixas. Isso ajuda a manter a fala estável, mas uma redução constante de 8 ou 10 dB pode trazer ruído de sala, respirações e reverberação para frente.
Para uma voz gravada em um quarto sem tratamento, comece com ratio de 2:1 ou 3:1, attack de 10 a 30 ms e release de 60 a 150 ms. Procure uma redução média de 2 a 4 dB. Ajuste pelo som e pelo medidor de redução, porque o mesmo número reage de forma diferente a uma entrevista e a uma locução.
O limiter deve cuidar de picos ocasionais, não decidir o volume da música em cada palavra. Se ele trabalha o tempo todo, o áudio pode perder transientes e ganhar uma aspereza que aparece primeiro nas consoantes. Deixe uma margem de segurança no master e resolva a relação entre voz e trilha nos canais individuais.
Faça um teste simples: desligue o limiter do master, abaixe a música manualmente até entender toda a frase e só depois reative a proteção de pico. Se a voz só fica inteligível com o limiter comprimindo vários decibéis, a automação ou o ganho de entrada ainda precisam de ajuste.
Como preservar a emoção da trilha
Uma queda fixa de 8 dB em toda fala pode resolver a inteligibilidade e matar a dinâmica da cena. A música precisa mudar de função conforme o texto: pode ficar mais presente durante uma pausa, recuar durante uma informação técnica e voltar com força depois de uma conclusão.
Separe a edição em três tipos de trecho:
- Informação densa: use mais redução, principalmente quando há nomes, números ou instruções.
- Fala emocional: reduza o suficiente para entender as palavras, mas preserve parte do corpo da trilha.
- Pausas e reação: devolva a música aos poucos para preencher o espaço sem cortar o clima.
Em uma entrevista gravada em uma sala grande, a reverberação da voz continua depois da palavra. Nesse caso, o retorno da música precisa esperar a cauda da sala, mesmo quando a forma de onda parece ter acabado. Em gravações secas, o retorno pode ser mais rápido.
Uma solução útil é dividir a música em dois trechos ou duplicar a faixa para criar versões com automações diferentes. Você pode manter uma base discreta sob a fala e deixar um trecho de impacto entrar apenas depois da frase. O custo é mais edição e mais cuidado com cortes, mas o resultado dá controle sem esmagar a trilha inteira.
Um método de escuta que revela erros escondidos
Monitore a mixagem em três níveis. Primeiro, escute em volume baixo. Se a voz some nesse ponto, a música provavelmente está ocupando espaço demais ou a região de presença da fala está irregular. Depois, confira em fones fechados para ouvir respiração, ruído e bombeamento. Por fim, use o alto-falante do celular, onde o grave da música desaparece e as frequências médias ficam expostas.
Faça também um teste sem olhar para a tela. Leia a transcrição ou peça a outra pessoa para anotar as palavras que não entendeu. Medidores mostram nível, mas não dizem se uma consoante foi coberta por um ataque de bateria.
No master, acompanhe o loudness integrado, medido em LUFS, que representa o nível médio percebido ao longo do programa. Plataformas e emissoras usam critérios diferentes, então não trate um número único como regra. Para publicar na web, evite normalizar uma versão já limitada sem verificar os picos verdadeiros e a perda de dinâmica.
O erro mais comum nessa etapa é ajustar a mixagem em fones caros e esquecer o dispositivo do público. Um diálogo que parece perfeito em monitores de estúdio pode perder clareza quando reproduzido em um celular apoiado sobre uma mesa.
Como organizar a sessão para corrigir a mixagem depois
Nomeie as pistas antes de automatizar: VOZ_PRINCIPAL, ENTREVISTA_02, MUSICA_BUS e SFX_BUS. Coloque a automação principal no bus da música e mantenha o ducking em um compressor separado. Assim, você consegue desligar cada camada e descobrir qual delas está causando a queda de volume.
Salve uma versão sem processamento pesado. Ela permite revisar a mixagem depois de mudar a duração de uma cena, trocar a narração ou substituir a trilha. Renderizar tudo em um único arquivo cedo demais transforma uma correção de dois minutos em uma reconstrução da sessão.
Se o projeto também tiver imagens de monitores ou telas, resolva a captura antes da edição. O ajuste de velocidade do obturador pode evitar barras e pulsação, como explica este guia sobre Como filmar monitor sem flicker: ajuste fino na câmera. Para vídeos de produto, o controle de contorno na luz reduz correções visuais que acabam competindo com a atenção dada ao áudio; veja Como fotografar produtos brancos no celular: contorno.
O espaço de gravação muda a quantidade de ducking necessária
Uma sala reverberante exige mais cuidado do que um ambiente seco. Em uma locação com paredes duras, a fala continua no ambiente depois da palavra, e a música pode retornar cedo demais. Faça um teste de dez segundos antes da gravação principal para ouvir a cauda da sala e decidir o tempo de release.
Locações como a Casa Primavera - Localcine e a Galeria Ricardo Von Brusky - Localcine podem atender propostas visuais diferentes, mas o áudio ainda depende da posição do microfone, das superfícies próximas e do ruído no horário da filmagem. Grave alguns segundos de som ambiente em cada posição. Esse arquivo ajuda a escolher entre uma redução musical mais leve e uma limpeza maior da voz.
Se a produção usa microfone de lapela, confira o atrito na roupa antes de pensar na mixagem. Ruído de tecido e reverberação não desaparecem com ducking. Eles podem até fazer o compressor da voz trabalhar mais, aumentando o problema que você tentava corrigir.
Checklist final para mixar voz e música
Antes de exportar, confira estes pontos:
- A voz continua compreensível no celular e em volume baixo?
- A música começa a baixar antes da primeira palavra?
- O retorno acontece depois da última consoante e da cauda da sala?
- O ducking reduz poucos decibéis além da automação, em vez de dominar a mixagem?
- O compressor da voz controla variações sem trazer ruído para frente?
- O limiter protege picos sem trabalhar em todas as frases?
- As pausas continuam naturais e a trilha recupera impacto entre os blocos de fala?
A melhor mixagem costuma ter uma curva que o público não percebe. Desenhe a automação ouvindo a frase completa, use o ducking para pequenas correções e deixe compressor e limiter em funções limitadas. Assim, a voz permanece inteligível e a música continua contando parte da cena.